Kurz gesagt
Der chinesische Investor Meng Xing hörte im August 2026 bei Gesprächen mit Leuten von OpenAI, Google und xAI immer wieder, man komme gegen die chinesischen Modelle nicht an, besonders bei Bild und Video. Beim Programmieren und beim grossen Reinforcement Learning sieht er die USA vorn. Chinesische Modelle machten im vergangenen Jahr 41 Prozent aller Downloads auf der Plattform Hugging Face aus. Wer ein offenes Modell auf eigenen Servern betreibt, behält seine Daten im Haus. Die ETH Zürich, die EPFL und das CSCS haben im Juli 2026 ihr offenes Modell Apertus in Version 1.5 veröffentlicht.
August 2026. Meng Xing reist ins Silicon Valley. Er ist Partner beim chinesischen Risikokapitalgeber 5Y Capital, früher war er operativer Chef der Sparte für autonomes Fahren beim Fahrdienst Didi. Er trifft Leute von OpenAI, von Google, von xAI. Und hört immer wieder denselben Satz.
打不过国内.
Vier Schriftzeichen, sinngemäss: Gegen die Leute daheim kommen wir nicht an. 国内 heisst wörtlich «im Inland». Wer so spricht, meint mit Inland China.
Am direktesten sagt es ihm ein Forscher von Google, der an Modellen für Bild, Video und Text arbeitet. Crossing the River übersetzt seinen Satz mit «We can’t beat the Chinese models». Wir schlagen die chinesischen Modelle nicht.
Am 18. September erschien Mengs Bericht im chinesischen Wirtschaftsmedium LatePost. Der Newsletter Crossing the River übersetzte ihn am 13. Oktober ins Englische, tags darauf verbreitete ihn der Newsletter TLDR.
Seit 2010 reise ich regelmässig nach China, meist nach Shenzhen.
Mengs Text ist kein Triumphgeheul. Er ist genauer.
Wo China vorne liegt
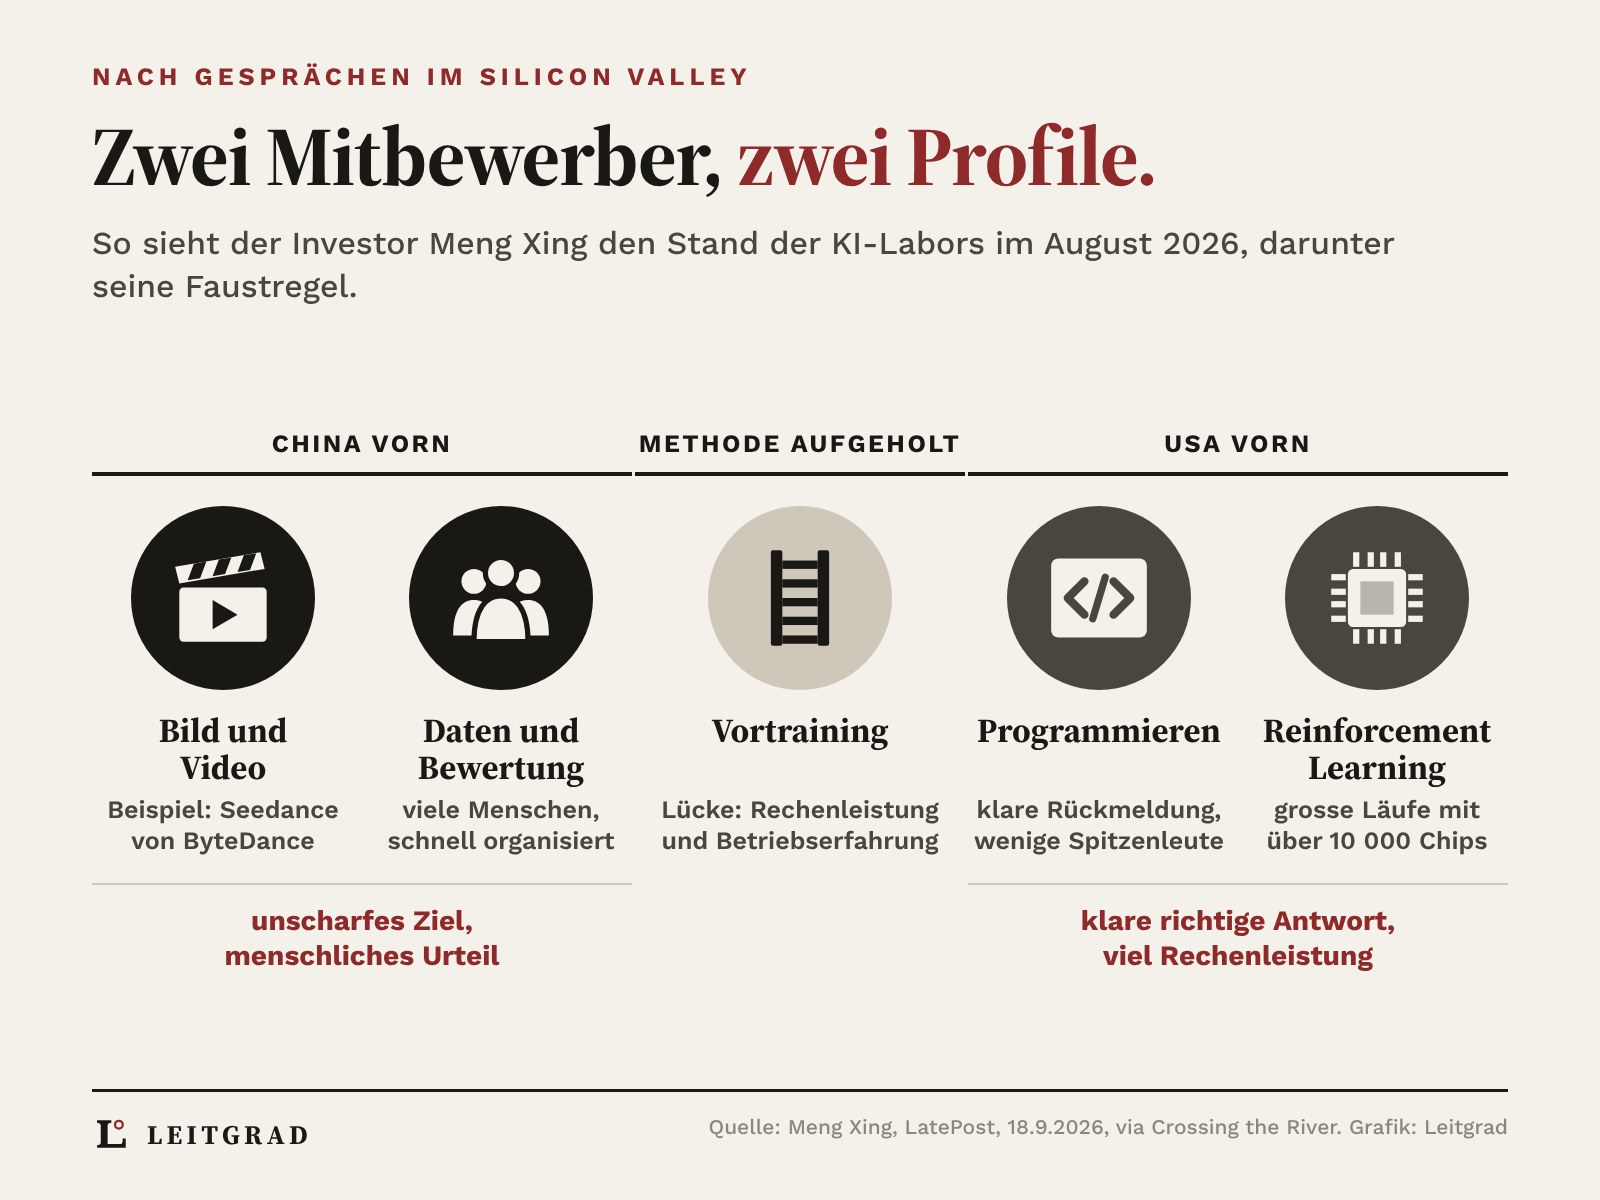
Beim Vortraining, dem ersten grossen Lernschritt eines Modells, hat China methodisch aufgeholt, schreibt Meng. Die führenden Labors prüfen Daten, Architektur und Verfahren erst an kleinen Modellen, bevor sie gross trainieren. Diese «Skalierungsleiter» sei 2026 deutlich ausgereifter. Was fehlt, sind Rechenleistung und die Erfahrung, Zehntausende Grafikprozessoren gleichzeitig zu betreiben.
Echten Vorsprung sieht Meng im Feinschliff danach. «Sobald das Ziel klar ist, wird alles Weitere sehr chinesisch», schreibt er im Original. Man organisiere schnell sehr viele Menschen und schiebe Daten, Annotation, Bewertung und Training Runde um Runde nach oben.
Sein Beispiel ist Seedance, das Videomodell von ByteDance. Weil ByteDance auch die Plattform betreibt, auf der Videos geschaut werden, weiss die Firma genau, was Nutzer unter einem guten Video verstehen. Meta soll laut Meng ein internes Team von rund 6500 Leuten aufgebaut haben, um genau diese Arbeitsweise nachzubilden.
Wo Kalifornien vorne bleibt
Die tiefste Lücke liegt beim Reinforcement Learning in grossem Massstab, dem Lernen durch Versuch und Belohnung. Ein einzelner Lauf belegt dort mehr als 10 000 Chips, eine Aufgabe kann tausend Schritte dauern. «China hatte bisher nicht so viele Chips und hat nicht oft genug in dieser Grösse trainiert», schreibt Meng. Diese Lücke sei tiefer als jene beim Vortraining.
Davon hängt das Programmieren ab. Wer Code schreibt, bekommt eine klare Rückmeldung: Er läuft oder er läuft nicht. Das belohnt grosse, stabile Trainingsläufe und wenige Spitzenleute. Die besten Programmierdaten von Anthropic stammen laut Meng vor allem von rund 100 Elite-Entwicklern im eigenen Haus.
Seine Faustregel: Wo das Ziel unscharf ist und Qualität vom menschlichen Urteil abhängt, spielt China seine Stärken aus. Wo es eine saubere richtige Antwort gibt und sich das Üben automatisieren lässt, gewinnen Rechenzentren und Spitzenkräfte. Zwei Mitbewerber, zwei Profile.
Das Regal der offenen Modelle
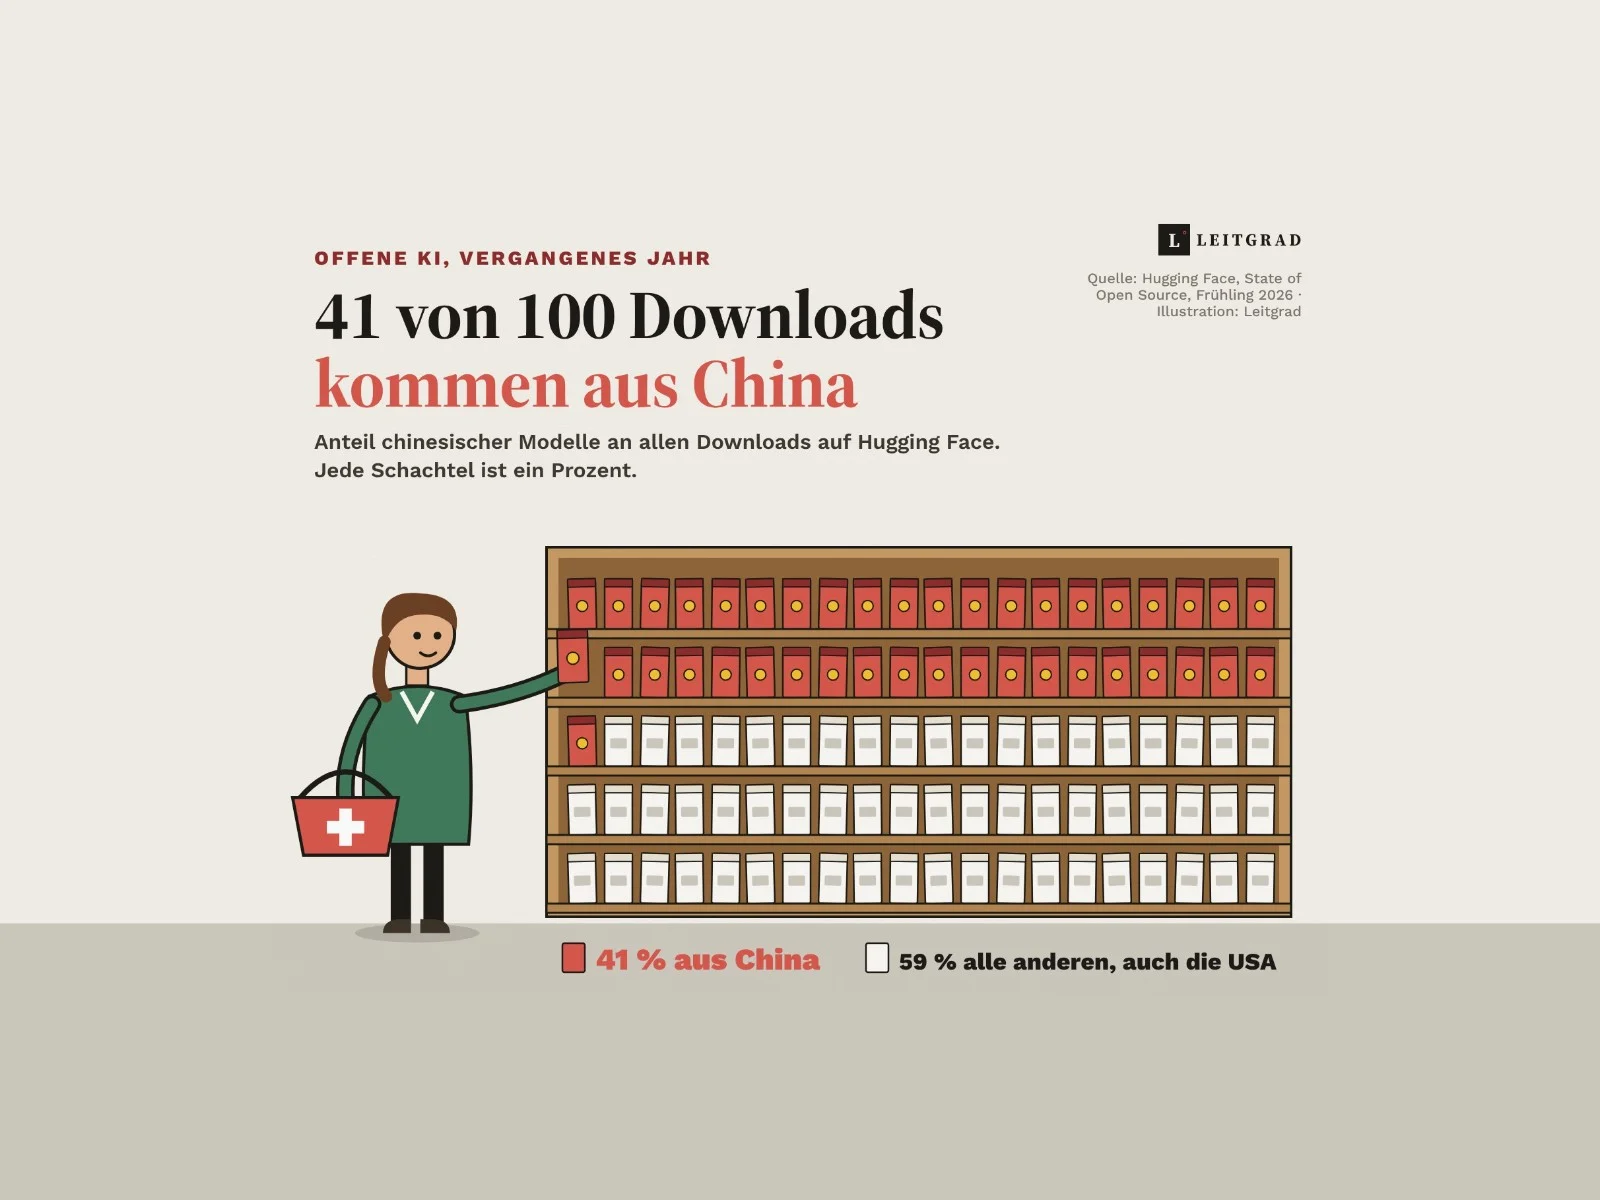
Am deutlichsten zeigt sich Chinas Stärke dort, wo jeder zugreifen kann. Auf Hugging Face, der grössten Plattform für offene KI-Modelle, stammten im vergangenen Jahr 41 Prozent aller Downloads von chinesischen Modellen. China überholte damit die USA, zeigt der Bericht der Plattform vom März 2026. Allein auf der Qwen-Familie von Alibaba bauen über 113 000 abgeleitete Modelle auf.
Viele dieser Modelle sind grosszügig lizenziert. Qwen3 steht unter der Lizenz Apache 2.0. DeepSeek-R1 steht unter der MIT-Lizenz und erlaubt ausdrücklich kommerzielle Nutzung und das Weitertrainieren anderer Modelle. Selbst einige junge Labors in den USA trainieren laut Meng mit den Antworten von K3, dem offenen Spitzenmodell von Moonshot AI.
Was das für eine Firma in Zug oder St. Gallen heisst
Für Schweizer Firmen ist das zuerst eine gute Nachricht. Mehr starke Modelle heisst mehr Auswahl. Entscheidend ist nicht, woher ein Modell stammt, sondern wo es rechnet.
Wer die App oder die Schnittstelle eines Anbieters nutzt, schickt seine Eingaben auf dessen Server. Für China sei das Datenschutzniveau «deutlich tiefer», sagte der Eidgenössische Datenschutzbeauftragte (EDÖB) Anfang 2025 zur App von DeepSeek, berichtete die Netzwoche. Personendaten dürfen ohne besondere Garantien nur in Staaten gehen, die der Bundesrat als angemessen anerkennt, erklärt das Bundesamt für Justiz. China gehört nicht dazu.
Wer dagegen ein offenes Modell herunterlädt und auf eigenen Servern oder in einer Schweizer Cloud betreibt, gibt keine Eingaben an den Hersteller weiter. Das Modell kommt aus Hangzhou, die Daten bleiben in Winterthur.
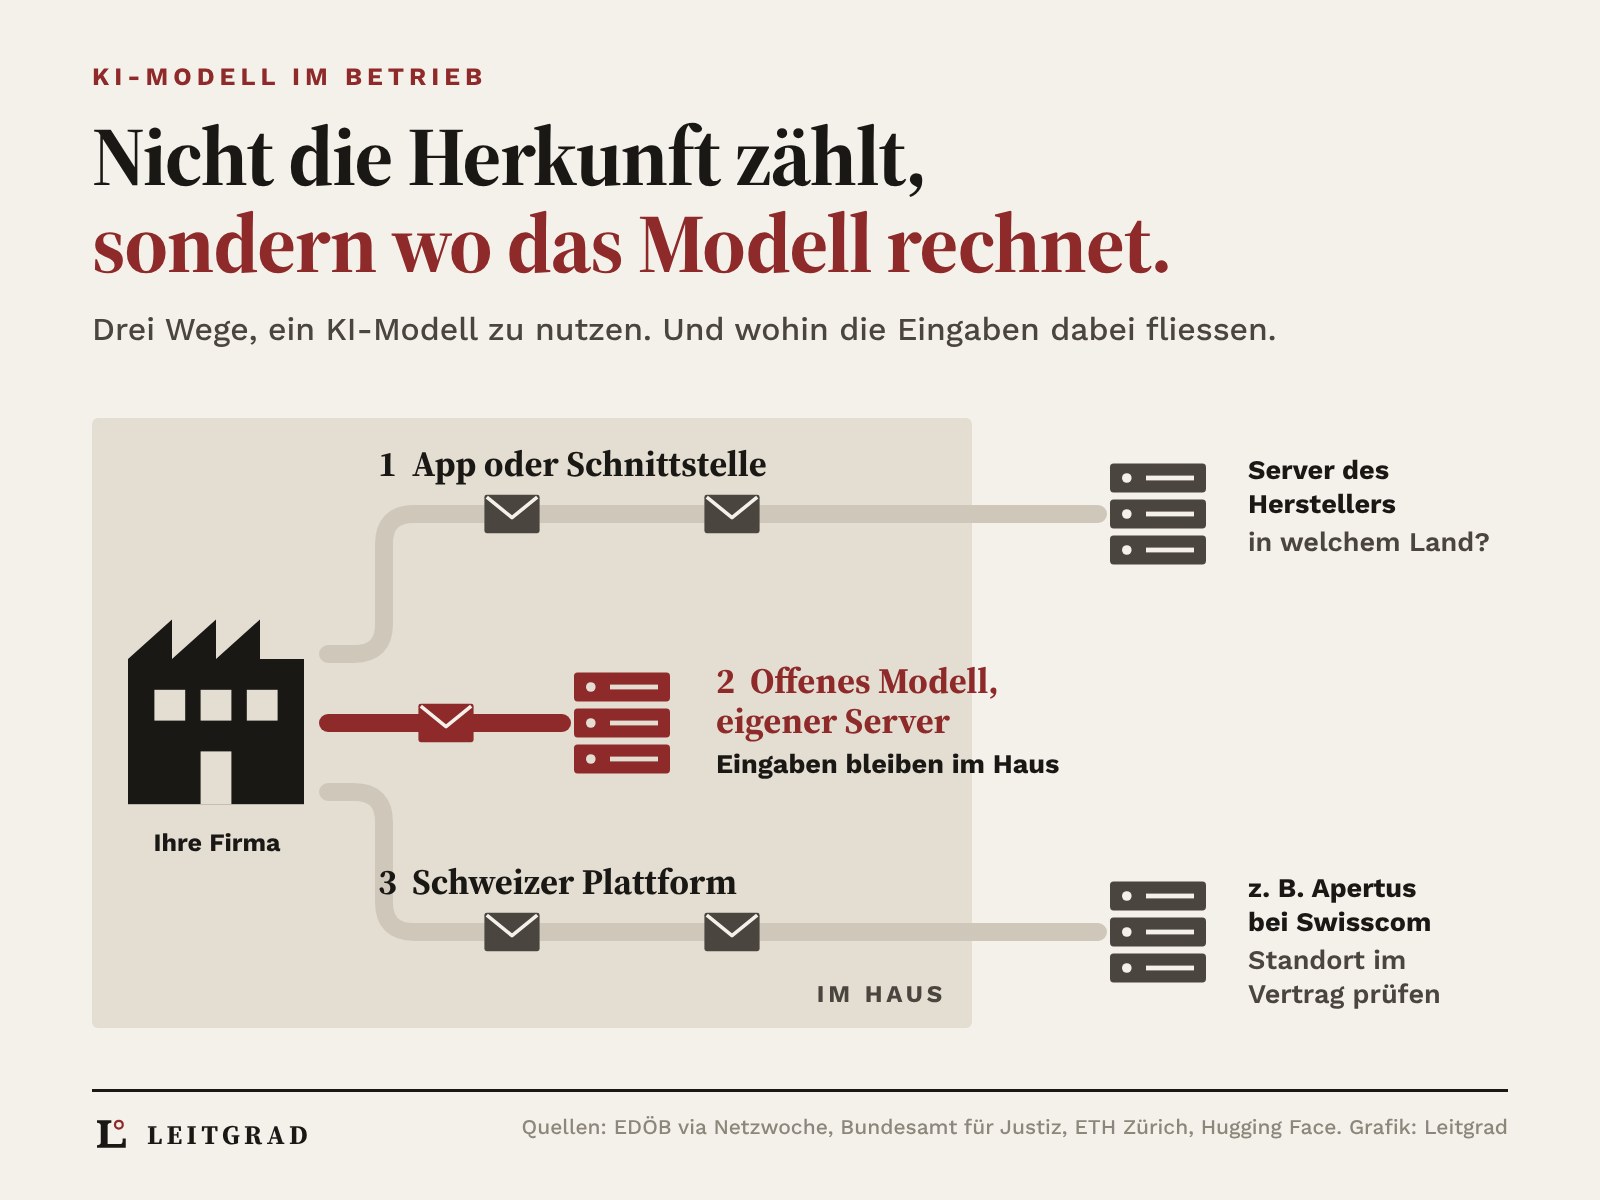
Und es gibt eine Schweizer Antwort. Am 2. September 2025 veröffentlichten die EPFL, die ETH Zürich und das Nationale Supercomputing-Zentrum CSCS Apertus, ein Sprachmodell mit 8 und 70 Mrd. Parametern, trainiert mit 15 Billionen Textbausteinen in über 1000 Sprachen. 40 Prozent der Daten sind nicht englisch, darunter Schweizerdeutsch und Rätoromanisch. Offen ist der gesamte Prozess: Architektur, Modellgewichte, Trainingsdaten und Methoden. Beim Bau berücksichtigt wurden das Schweizer Datenschutz- und Urheberrecht, schreibt die ETH. Geschäftskunden von Swisscom können es über deren Swiss AI Platform nutzen.
Am 24. Juli 2026 folgte Apertus 1.5. Es versteht neu auch Bilder und Ton, kann besser schlussfolgern und Werkzeuge nutzen, dazu kommen 16 kompakte Modelle für kleine Rechner. Die Lizenz ist Apache 2.0. Der Kanton Tessin übersetzt bereits damit.
Meng beendet seinen Text auf den Färöer-Inseln. Er hatte Tage ohne KI geplant. Dann übersetzte ChatGPT für ihn mit den Taxifahrern, die Färöisch und Dänisch sprachen. Modelle können tausend Leben durchspielen, schreibt er, ein Mensch hat eines. Wohin man seine Zeit gibt, lässt sich nicht delegieren.
Welches Modell eine Firma einsetzt, gehört zu dieser Sorte Entscheid.
Zum Mitnehmen: Worauf man bei der Wahl eines KI-Modells achtet
- Wo rechnet das Modell? App oder Schnittstelle des Herstellers, eigener Server oder Schweizer Plattform. Davon hängt ab, wohin Eingaben und Personendaten fliessen.
- Dürfen die Daten dorthin? Personendaten dürfen ohne zusätzliche Garantien nur in Staaten gehen, die der Bundesrat als angemessen anerkennt (Bundesamt für Justiz).
- Was erlaubt die Lizenz? Apache 2.0 (Qwen3, Apertus 1.5) und MIT (DeepSeek-R1) erlauben kommerzielle Nutzung. Andere Modelle haben eigene Bedingungen, die man vor dem Einsatz liest.
- Taugt es für die eigene Aufgabe? Stärken unterscheiden sich je nach Aufgabe, etwa Bild und Video gegenüber Programmieren (Meng). Ein Test mit echten Beispielen aus dem eigenen Alltag sagt mehr als jede Rangliste.
- Spricht es die Sprachen der Kundschaft? Deutsch, Französisch, Italienisch, bei Bedarf Schweizerdeutsch. Apertus wurde ausdrücklich auch dafür trainiert (ETH).
- Wie offen ist die Herkunft? Bei vollständig offenen Modellen wie Apertus sind Trainingsdaten und Methoden einsehbar, bei vielen anderen nur die Gewichte.
- Weiss die Kundschaft Bescheid? Nach dem Datenschutzgesetz müssen Betroffene erfahren können, ob sie mit einer Maschine korrespondieren, so der EDÖB (Netzwoche).
Häufige Fragen
Sind chinesische KI-Modelle besser als amerikanische?
Je nach Aufgabe. Nach der Einschätzung des Investors Meng Xing liegen chinesische Labors bei Bild und Video sowie bei der Arbeit mit vielen Menschen an Daten und Bewertung vorn, amerikanische beim Programmieren und beim Reinforcement Learning in grossem Massstab. Bei offenen Modellen kamen im vergangenen Jahr 41 Prozent der Downloads auf Hugging Face aus China.
Darf ein Schweizer Unternehmen DeepSeek oder Qwen nutzen?
Das Datenschutzgesetz regelt nicht das Modell, sondern den Umgang mit Personendaten. Wer ein offenes Modell auf eigenen Servern betreibt, gibt keine Eingaben an den Hersteller weiter. Wer die App oder Schnittstelle in China nutzt, muss die Regeln für die Bekanntgabe von Personendaten ins Ausland beachten.
Was ist Apertus?
Ein vollständig offenes Sprachmodell der EPFL, der ETH Zürich und des CSCS, erstmals veröffentlicht am 2. September 2025. Version 1.5 vom Juli 2026 versteht auch Bilder und Ton und steht unter der Lizenz Apache 2.0.
Quellen
- Meng Xing, 当硅谷开始说「打不过国内」, LatePost, 18. September 2026 (via NetEase) 163.com
- Crossing the River, Silicon Valley, Seen from Beijing, 13. Oktober 2026 substack.com
- TLDR, Newsletter vom 14. Oktober 2026 tldr.tech
- Hugging Face, State of Open Source on Hugging Face: Spring 2026, 17. März 2026 huggingface.co
- Modellkarten Qwen3 und DeepSeek-R1 auf Hugging Face Qwen3 · DeepSeek-R1
- Netzwoche, Deepseek wirft Datenschutzbedenken auf, 3. Februar 2025 netzwoche.ch
- Netzwoche, So betrifft das Schweizer Datenschutzgesetz KI-Anwendungen, 12. Mai 2025 netzwoche.ch
- Bundesamt für Justiz, Anerkennung von Staaten mit angemessenem Datenschutz, 5. Februar 2026 bj.admin.ch
- ETH Zürich, Apertus: ein vollständig offenes, transparentes und mehrsprachiges Sprachmodell, 2. September 2025 ethz.ch
- CSCS, ETH Zürich und EPFL, Apertus 1.5, 24. Juli 2026 cscs.ch
Erschienen am 9. November 2026, 16:47 Uhr. Aktualisiert am 11. November 2026, 07:26 Uhr. Jede Zahl prüfen wir an der Primärquelle. Fehler gefunden? Hinweis an die Redaktion
Themen folgen
Merag Shahzad ist Gründer, Herausgeber und Chefredaktor von Leitgrad, dem Schweizer Wirtschaftsmagazin für Inhaber und Führungskräfte. Seit 15 Jahren arbeitet er in Content-Marketing und digitaler PR und setzt diese Erfahrung heute vor allem für Leitgrad ein. Daneben gründete er die GEO-Agentur meit.
Zur AutorenseiteWie Leitgrad arbeitetLeitgrad Morgen-Briefing: jeden Werktag das Wichtigste für Ihre Firma. Lesen · Anhören · Per Mail